AI 모델 SBOM 가이드
HuggingFace 모델의 CycloneDX ML-BOM(머신러닝 SBOM)을 생성하고 결과를 읽는 방법입니다. 모델 id만 주면 BomLens가 모델 카드 메타데이터를 네트워크로 가져옵니다. 소스 코드도, 모델 가중치 다운로드도 필요 없습니다.
동작 방식
AI 모델의 "구성요소 명세"는 모델 카드입니다. 식별자, 아키텍처, 태스크, 라이선스, 공급자, 데이터셋, 파일 무결성 등이 담깁니다. BomLens는 OWASP AIBOM Generator로 HuggingFace 모델 카드를 읽어 모델과 참조 데이터셋 중심의 CycloneDX 1.7 ML-BOM을 만들고, G7 최소 요소 적합성 검사(권고)를 더합니다. 모델에는 패키지 의존성이 없으므로 보안(CVE) 보고서는 생성하지 않습니다.
문서가 기술하는 대상은 모델입니다. CycloneDX가 SBOM의 대상을 적는 자리인 metadata.component에 모델이 들어가고, 참조하는 데이터셋은 그 의존 항목으로 components[]에 들어갑니다. ML-BOM을 읽는 도구는 구성요소 목록이 아니라 이 자리에서 모델을 찾아야 합니다.
모델 카드는 학습 데이터셋의 이름만 적고 끝납니다. BomLens는 각 데이터셋을 HuggingFace에서 조회해 표기된 라이선스, 파생 출처, 콘텐츠 해시를 SBOM에 별도 항목으로 담고 모델과 의존 관계로 연결합니다. 읽을 수 없는 데이터셋(삭제·개명되었거나 다른 사람의 비공개 저장소)은 이름만 남기고 읽을 수 없음으로 표시하며, 라이선스를 임의로 채우지 않습니다. 학습 데이터 공개 축도 이 결과로 정해집니다. open-data가 되려면 실제로 열린 데이터셋이 하나 이상 있어야 하고, 이름만 적혀 있고 아무도 받을 수 없으면 declared-unverified로 표시됩니다.
데이터셋 카드도 자신이 만들어진 원천 데이터셋을 적을 수 있습니다(source_datasets). BomLens는 이 원천도 같은 방식으로 따라가며, 최대 3단계 아래까지, 스캔 한 번에 최대 40개 데이터셋까지 조회합니다(AIBOM_DATASET_DEPTH, AIBOM_DATASET_MAX_LOOKUPS. 깊이를 0으로 두면 모델 카드가 적은 데이터셋만 읽습니다). 원천마다 별도 항목이 되고 그 원천에서 나온 데이터셋과 연결됩니다. 그래서 허용적인 라이선스로 공개된 혼합 데이터셋 안에 더 좁은 조건의 원천이 있으면 그것이 드러납니다. HuggingFace 데이터셋 id 형태인 값만 조회하며, HF_ENDPOINT가 설정되어 있으면 그 주소로 조회합니다. 카드가 문장으로 적은 원천("Wikipedia dump 2023-01", extended|other)이나 자리표시 값(extended만 적은 경우, unknown, N/A)은 적힌 그대로 남기고 검토 필요로 표시합니다. 이름이 비슷한 데이터셋을 찾아 맞추거나 추정하지 않습니다. 대부분의 데이터셋 카드는 원천을 적지 않으므로, 이 기능이 정보를 더하는 것은 주로 학습용 혼합 데이터셋 같은 일부 데이터셋입니다.
전체 도구 흐름은 입력 형태별 파이프라인에 있습니다.
시작하기 전에
필요한 것은 두 가지입니다.
- Docker 엔진이 설치되어 실행 중일 것. 없다면 시작하기의 요구 사항을 먼저 보세요.
- 실행 방법 하나. 데스크톱 앱을 쓰면 명령어가 필요 없고, 명령줄로 쓰려면 시작하기에서 저장소를 내려받습니다. AI 모델 스캔에는 OWASP AIBOM Generator가 들어 있는 별도 이미지가 필요합니다. opt-in이고 네트워크(HuggingFace)에 접근하므로 기본 이미지와 분리했습니다.
이 이미지는 다운로드 기준 약 3.5GB로 기본 스캐너 이미지(약 250MB)보다 훨씬 큽니다. 회선에 따라 처음 받는 데 수십 분이 걸릴 수 있으니 시간을 두고 시작하세요. 한 번 받으면 다시 받지 않습니다.
미리 받지 않아도 됩니다. --model을 쓰면 이 이미지가 기본값이라 없을 때 알아서 받고, 웹 UI와 데스크톱 앱도 첫 AI 모델 스캔에서 받으면서 진행 상황을 보여 줍니다. 다른 태그를 쓰려면 환경변수 SBOM_AIBOM_IMAGE로 지정합니다.
실행하기
웹 UI에서
데스크톱 앱이나 평소 쓰던 웹 UI를 그대로 쓰면 됩니다. Docker에 접근할 수 있으면 AI 모델 타일이 활성화되고, aibom 이미지는 첫 스캔에서 별도 컨테이너로 받아 실행합니다. 처음 한 번은 이미지를 받느라 시작이 느립니다.
aibom 이미지로 UI 자체를 띄우면 별도 컨테이너 없이 UI 안에서 바로 처리합니다. Docker 소켓을 쓸 수 없는 환경에서 필요합니다.
SBOM_SCANNER_IMAGE=ghcr.io/sktelecom/bomlens-aibom:latest ./scripts/scan-sbom.sh --ui
#   Windows: sbom-ui.bat 더블클릭 전에 SBOM_SCANNER_IMAGE를 지정
새 스캔의 소스 타일에서 AI 모델을 고르고, HuggingFace 모델 id를 org/model 형식으로 입력한 뒤(예: google-bert/bert-base-uncased, Qwen/Qwen2.5-0.5B — 컬렉션 이름이나 전체 URL이 아닌) 스캔을 실행합니다.
CLI에서
모델 id를 --model에 넘깁니다.
./scripts/scan-sbom.sh --project bert-base --version 1.0.0 \
  --model "google-bert/bert-base-uncased" --generate-only
--model은 --target, --analyze, --git, --merge와 함께 쓸 수 없습니다. bomlens-aibom 이미지를 자동으로 받고, 고지문과 위험 보고서를 만들며, 보안 보고서는 건너뜁니다(모델에는 패키지 CVE가 없음).
비공개 모델과 게이트 모델
공개 모델 id는 인증 없이 해석됩니다. 비공개 저장소나 접근 승인을 받은 게이트 저장소는 read 권한을 가진 HuggingFace 액세스 토큰을 HF_TOKEN에 넣어야 합니다.
HF_TOKEN=hf_... ./scripts/scan-sbom.sh --project my-llm --version 0.9.0 \
  --model "my-org/my-llm" --generate-only
HUGGING_FACE_HUB_TOKEN도 받습니다. 토큰 값은 이름만으로 컨테이너에 전달되고 명령줄 인자로는 넘어가지 않으므로 프로세스 목록에 노출되지 않으며, SBOM이나 보고서에도 기록되지 않습니다.
모델을 공개하기 전에 검토할 수 있는 방법이 여기에 있습니다. 비공개 저장소에 먼저 올려 ML-BOM을 만들고, 적합성 검사 보고서가 알려주는 공백을 메운 다음 저장소를 공개하면 됩니다. 게이트 저장소는 토큰만으로는 부족하고 해당 계정의 접근 요청이 승인되어 있어야 합니다. 모델의 학습 데이터셋을 조회할 때도 같은 토큰을 쓰므로, 데이터가 비공개 저장소에 있는 모델도 토큰이 필요합니다.
웹 UI는 자신을 실행한 환경에서 같은 변수를 물려받으므로 HF_TOKEN=hf_... ./scripts/scan-sbom.sh --ui 형태로 시작하면 됩니다. 화면에는 토큰 입력란이 없습니다. 서버는 자격 증명을 보관하지 않으며, HTTP로 받은 토큰은 서버 로그에 남기 때문입니다.
모델 파일 스캔
여기까지는 모델 id에서 출발하며, 그 모델이 HuggingFace에 있다고 전제합니다. 그렇지 않은 경우가 많습니다. 공급사가 가중치 파일을 그대로 보내오거나, 사내에서 추가 학습한 모델이거나, 네트워크가 없는 환경일 수 있습니다. 이때는 파일을 직접 가리킵니다.
./scripts/scan-sbom.sh --project internal-llm --version 1.0.0 \
  --model-file ./models/internal-llm-q4.gguf --generate-only
웹 UI에서는 AI 모델 아래 모델 파일을 골라 업로드합니다(최대 8GB). 그보다 큰 파일은 CLI를 쓰십시오. CLI는 파일을 그 자리에서 읽으므로 전송이 없습니다.
읽는 것은 파일의 헤더뿐이고 따로 받아 오는 이미지도 없습니다. 기본 이미지에서 오프라인으로 동작합니다. 형식은 파일 이름이 아니라 매직 바이트로 판별하며, 둘이 어긋나면 조용히 고치지 않고 컴포넌트에 그 사실을 기록합니다.
| 형식 | 파일에서 얻을 수 있는 것 |
|---|---|
| GGUF | 모델 이름, 라이선스, 아키텍처, 양자화 정보, 텐서 개수 |
| safetensors | 텐서 개수, dtype, 파라미터 수, 그리고 선택 항목인 __metadata__ 블록이 선언한 값(라이선스인 경우가 많음) |
PyTorch(.pt/.pth/.ckpt), pickle |
아카이브 구성과 가중치가 pickle 형식이라는 사실 |
Keras(.h5/.keras) |
형식 자체와 Lambda 레이어 존재 여부 |
| npz, npy | 내부 항목 목록 |
| ONNX | 형식 자체(자세한 메타데이터는 protobuf 파서가 필요) |
어떤 형식이든 파일 크기와 파일 전체의 SHA-256은 기록합니다. 이 값이 받은 파일과 문서를 잇습니다. 파일이 선언하지 않은 값은 넣지 않습니다. 라이선스가 없는 가중치는 라이선스 없는 SBOM이 되고, 위험 판정은 침묵을 허락으로 읽지 않고 review로 남깁니다.
불러올 때 코드가 실행되는가
pickle은 데이터 형식이 아닙니다. 불러오는 순간 스트림이 지시하는 코드를 그대로 실행하므로, 이 형식의 체크포인트는 그 자체가 위험 요소입니다. 라이선스와도, CVE와도 별개입니다. Keras .h5/.keras 파일도 형태만 다를 뿐 같은 종류의 위험을 가집니다. Lambda 레이어에 marshal로 직렬화한 파이썬 함수를 담을 수 있는데, 이 함수는 Keras가 레이어를 복원할 때 실행됩니다. HuggingFace에 있는 모델은 Hub가 돌린 검사 결과를 읽어 옵니다. 공개하지 않은 파일은 그런 기록이 없으므로 여기서 직접 검사합니다. pickle 계열 형식은 Hub와 같은 도구인 picklescan을, Keras는 Lambda 표식을 찾는 단순 텍스트 검사를 씁니다. 복원할 필요 없이 찾을 수 있는 표식이기 때문입니다.
판정은 모델 컴포넌트에 기록되고 위험 판정의 파일 보안 축에 반영됩니다.
| 판정 | 뜻 | 위험 등급 |
|---|---|---|
| 코드를 실행하는 항목 발견 | pickle 스트림에서 os.system 같은 위험한 항목에 닿을 수 있음 |
caution |
| 확인이 필요한 항목 있음 | 코드가 될 수 있는 pickle 항목(대개 사용자 정의 클래스), 또는 Lambda 레이어가 있는 Keras 파일 |
review |
| 코드를 실행하는 위험 없음 | pickle 데이터에 그런 항목이 없거나, Keras 파일에 Lambda 레이어가 없음 |
ok |
| 코드를 실행하지 않는 형식 | GGUF, safetensors, ONNX, 일반 npy | ok |
| 읽지 못함 | 파일이 해석되지 않음 | review |
가운데 두 줄은 짚어 둘 것이 있습니다. "확인이 필요한 항목"은 멀쩡한 체크포인트에서도 흔합니다. 모델이 자체 클래스를 담고 있거나, 평범한 활성화 함수를 위해 Lambda 레이어를 썼어도 걸립니다. 그래서 경보를 울리지 않고 사람이 보도록 남깁니다. 그리고 깨끗하다는 결과는 질문 하나에만 답한 것입니다. 이 경로로는 불러올 때 코드를 실행하지 않는다는 뜻이지 파일에 아무 문제가 없다는 뜻이 아닙니다. pickle은 pickle 분석이지 악성코드 검사가 아니고, Keras는 Lambda 표식을 찾는 텍스트 검색이지 모델 구성을 해석한 것이 아닙니다.
.npz는 열어서 실제로 pickle을 담은 항목만 검사합니다. dtype이 object인 numpy 배열은 내용을 pickle로 저장하는데, 숫자 배열처럼 보이는 파일에 페이로드가 숨는 경로가 여기입니다. 그런 항목이 없는 파일은 깨끗함이 아니라 해당 없음으로 보고합니다. 검사한 것이 없기 때문입니다.
검사 자체가 돌지 못하면 판정을 남기지 않고, 위험 판정에 파일 보안 축이 아예 생기지 않습니다. 검사하지 않은 것은 안전으로 읽히지 않습니다.
이 경로가 할 수 없는 일
구조상 둘 있습니다. 모델 카드가 없으므로 학습 데이터와 사용 목적, 평가를 묻는 G7 항목은 공백으로 보고됩니다. 파일이 그에 관해 아무 말도 하지 않으니 정확한 보고입니다. 그리고 파일 하나를 기술하므로, 샤드 여러 개로 나뉜 모델은 지금은 샤드마다 따로 스캔합니다.
공개된 데이터셋 스캔
연구 데이터는 논문이 올려 둔 곳에 있고, 여러 분야에서 그곳은 모델 허브가 아니라 Figshare 같은 저장소입니다. HuggingFace 모델 id 대신 --model에 해당 항목을 그대로 넣습니다.
./scripts/scan-sbom.sh --project cell-imaging-data --version 1.0.0 \
  --model "https://figshare.com/articles/dataset/Title/33412285" \
  --usage product --generate-only
페이지 주소, DOI, 항목 번호 모두 됩니다. 최신 버전이 아니라 특정 버전을 읽으려면 버전이 표시된 주소나 DOI를 주면 됩니다(.../33412285/2, 10.6084/m9.figshare.33413521.v1). 계정도 별도 이미지도 필요 없습니다. 공개 항목 조회는 인증 없이 응답하고, 변환은 기본 이미지에 들어 있습니다.
항목은 CycloneDX data 컴포넌트가 되며 라이선스, DOI, 저자, 파일별 MD5 값을 담습니다. 표준 식별자로 옮길 수 있는 라이선스(Creative Commons 계열, MIT, Apache 2.0, GPL 계열, CC0)는 SPDX 식별자로 기록하고, 그 밖의 것은 추측하지 않고 표기 그대로 남깁니다. --usage는 모델과 마찬가지로 적용됩니다. 비상업 조건은 내부 연구용일 때와 외부에 제공할 때 의미가 다릅니다.
이름에 "figshare"가 없는 기관 DOI(10.25916/sut.33412285.v1)는 다른 DOI와 구분할 수 없으므로 항목 주소를 주십시오. 비공개, 엠바고, 철회된 항목은 계정 없이 읽을 수 없으며, 라이선스가 없는 데이터셋으로 기록하지 않고 오류로 알립니다.
HuggingFace에 있는 데이터셋도 같은 방법으로 스캔하며, 역시 기본 이미지에서 계정 없이 처리합니다. datasets/<owner>/<name>, https://huggingface.co/datasets/<owner>/<name>(이름 뒤의 /tree/main 같은 부분은 무시), hf:<owner>/<name> 중 하나로 주면 됩니다. HuggingFace가 모델과 데이터셋에 같은 형식을 쓰므로 앞에 아무것도 붙이지 않은 owner/name은 모델 id로 읽습니다. 데이터셋이라는 것은 접두어나 주소로 구분합니다.
./scripts/scan-sbom.sh --project tulu --version 1.0 \
  --model datasets/allenai/tulu-3-sft-mixture --generate-only
데이터셋은 SBOM의 루트 data 컴포넌트가 되며 라이선스, 조회한 허브 리비전(bomlens:dataset:revision), 파일별 SHA-256 값을 담습니다. 카드의 source_datasets에 적힌 데이터셋은 모델 카드가 적은 데이터셋과 같은 방식으로 따라가며(AIBOM_DATASET_DEPTH, AIBOM_DATASET_MAX_LOOKUPS 제한도 같음), 모델·데이터셋 화면에서 그 아래 행으로 표시되고, 각 원천의 위험 판정이 루트까지 반영됩니다. 접근 제한이 있거나 비공개인 데이터셋은 HF_TOKEN이 필요하며, 읽을 수 없는 데이터셋은 빈 SBOM으로 기록하지 않고 오류로 알립니다.
산출물: 고지문, ML-BOM(CycloneDX 1.7), 오픈소스 위험 보고서, 적합성 검사.
결과 읽기
웹 UI에서 AI/ML SBOM은 좌측 레일에 두 섹션을 추가합니다.
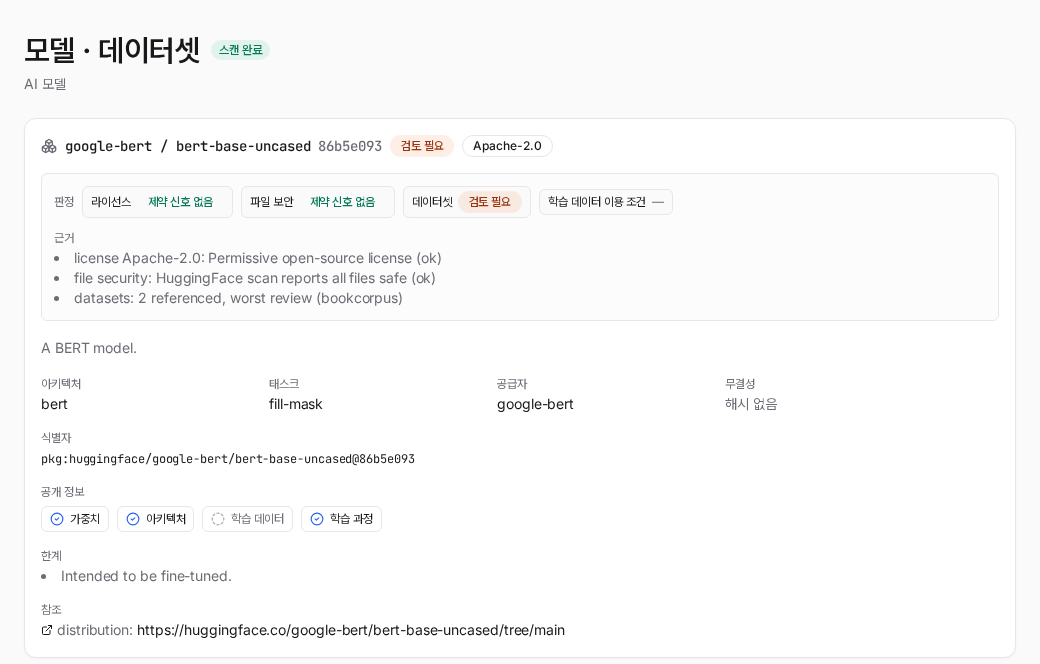
모델·데이터셋 — 각 모델 카드의 식별자, 아키텍처, 태스크, 라이선스, 공급자, 무결성과 공개 4축 패널(가중치 / 아키텍처 / 학습 데이터 / 학습 과정 — 모델 카드에 문서화된 범위), 그리고 모델이 참조하는 데이터셋을 표로 보여 줍니다. 표에는 각 데이터셋의 라이선스와 콘텐츠 해시, 파생 출처가 함께 나옵니다. 추적한 원천은 그 원천에서 나온 데이터셋 아래에 들여쓴 별도 행으로 나오고, 자체 판정과 라이선스를 함께 보여 줍니다. 그래서 데이터셋과, 그 데이터셋이 조건을 물려받은 원천을 나란히 비교할 수 있습니다.
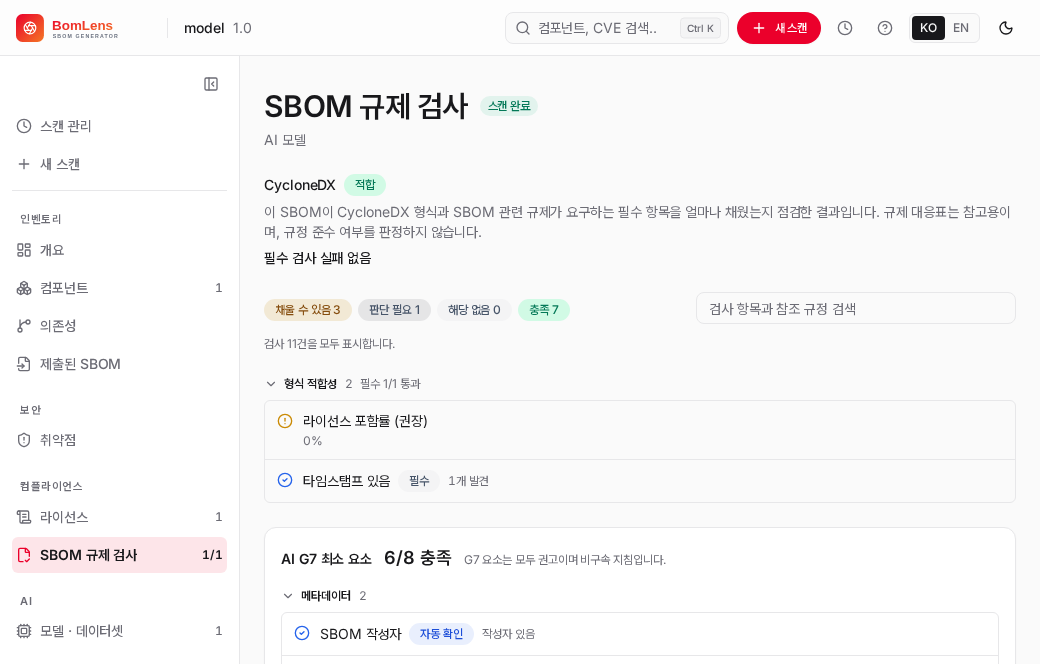
적합성 — AI 모델 SBOM에서는 이 섹션에 G7 최소 요소 검사(모두 권고)가 기본 형식 적합성 검사와 함께 더해지고, G7 7개 클러스터별로 묶입니다. 각 항목은 무엇인지와 어떻게 충족하는지를 안내합니다. 숫자와 배지가 뜻하는 바는 다음 절에서 설명합니다.
같은 데이터는 산출물에도 있습니다. ML-BOM(_bom.json, CycloneDX 1.7)과 적합성 검사 보고서(_conformance.*)입니다.
SPDX 3.0.1 AI 문서
모든 AI 모델과 데이터셋 스캔은 결과를 AI와 Dataset 프로파일을 쓴 SPDX 3.0.1 문서 {Project}_{Version}_bom.spdx3.json으로도 만듭니다. CycloneDX ML-BOM 옆에 생기며, 정본은 계속 CycloneDX 파일입니다. SPDX 문서는 그 파일과 모델 공개자가 선언한 내용으로 만듭니다.
스캔이 채울 수 있는 것은 읽은 내용입니다. 모델의 이름, 리비전, 내려받기 주소, 허브의 게시자, 라이선스, 아키텍처, 한계, 가중치 파일과 해시, 데이터셋 카드가 밝힌 주소와 라이선스와 데이터 종류, 카드가 적은 기반 모델과 데이터셋입니다. 모델의 출시일, 만든 주체, 학습에 쓴 데이터셋과 평가에만 쓴 데이터셋의 구분, 시작점이 된 기반 모델의 리비전은 스캔으로 알 수 없습니다. SPDX 3.0.1은 이 가운데 여러 항목을 필수로 두면서 "알 수 없음" 값을 주지 않으므로, 선언하기 전까지 문서는 초안입니다. 문서의 설명에 초안이라고 적고, {Project}_{Version}_spdx3-check.md가 비어 있는 필드를 하나씩 보여 줍니다.
채우려면 스캔이 만든 빈 선언 양식 {Project}_{Version}_ai-declaration.template.json을 고쳐서 다시 스캔합니다.
./scripts/scan-sbom.sh --project my-llm --version 1.0 \
  --model "acme/support-adapter" --ai-declare my-llm_1.0_ai-declaration.template.json --generate-only
선언한 값은 대부분 SPDX 문서에만 들어가고 값마다 선언이라고 표시합니다. 예외는 모델을 실행하는 서비스와, 모델의 입력과 출력 종류, 학습 연산량, 적대적 시험 여부입니다. 이 값들은 CycloneDX SBOM에도 들어갑니다(모델을 실행하는 서비스 참고). 스캔이 찾지 못한 데이터셋이나 기반 모델, 필드의 허용 목록에 없는 값, YYYY-MM-DDThh:mm:ssZ 형식이 아닌 날짜를 적은 선언은 이유와 함께 거부합니다. 도구가 대신 판단하지 않는 필드도 있습니다. 모델이 민감한 개인정보를 쓰는지, 안전 위험 등급, 자율성입니다. 검사 결과는 이 항목을 판단이 필요한 항목으로 보여 주며, 비워 둬도 됩니다. model.license(HuggingFace 라이선스 태그나 SPDX 라이선스 ID)는 스캔이 라이선스를 읽지 못했거나 other만 읽었을 때 모델 자체의 라이선스로 들어갑니다. 스캔이 읽은 라이선스와 다르면 스캔한 값을 유지하고 확인 필요로 보여 줍니다. SPDX 식으로 기록하는 것은 SPDX 라이선스 하나에 대응하는 허브 태그와 LicenseRef-뿐이고, 그 밖의 값은 문장으로 남기며 식은 NoAssertionLicense로 둡니다.
웹 UI에서는 파일을 고칠 필요가 없습니다. 모델·데이터셋 화면이 문서의 상태와 빈 항목 채우기 버튼을 보여 주고, 버튼을 누르면 비어 있는 항목을 단계별로 물어 선언으로 저장합니다(웹 UI 레퍼런스 참고). 저장된 선언은 같은 {Project}_{Version}_ai-declaration.json 파일이므로, CLI로 다시 스캔해도 그대로 적용됩니다.
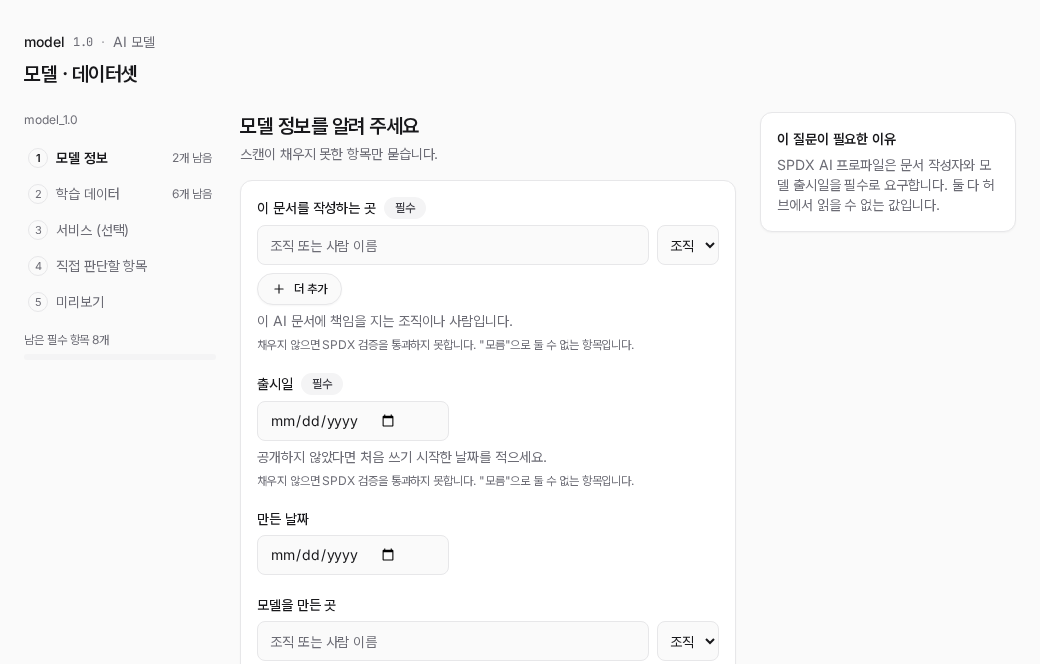
출시를 준비 중인 모델에는 스캔할 저장소나 파일이 없으므로, 선언만으로 기술할 수 있습니다. --model이나 --model-file 없이 --ai-declare <파일>만 주거나, 웹 UI 새 스캔 화면에서 모델 정보 직접 입력을 고릅니다. 이 타일은 같은 내용을 질문으로 묻고 그 답으로 스캔을 시작합니다.
./scripts/scan-sbom.sh --project support-bot --version 1.0 \
  --ai-declare support-bot-declaration.json --generate-only
모델은 프로젝트 이름과 버전으로 SBOM의 주 대상이 되고 bomlens:origin=declared-input으로 표시됩니다. model.baseModels[].ref에 적은 기반 모델과 datasets[].ref(huggingface:<owner>/<name>)에 적은 데이터셋은 허브에서 id로 읽으므로 계보, 라이선스, 원천 추적 결과가 모델 스캔과 같고, 허브에 없는 데이터는 datasets[].local에 적습니다. 위험 판정, G7 검사, 이 문서는 평소처럼 이어집니다. 내려받기 주소와 공급자는 어느 허브에서도 얻을 수 없으므로, 선언할 때까지 문서는 초안으로 남습니다.
이 경우에는 SBOM 전체가 공개자의 진술이므로 선언 값 두 가지가 SBOM에 들어갑니다. --sbom-author를 주지 않으면 document.createdBy에 적은 이름이 SBOM 작성자가 되고, bomlens:sbom-author-source=declaration으로 표시됩니다. 다른 하나는 모델 자체의 라이선스 model.license입니다. 위험 판정은 이 라이선스로 모델을 판정하고, 같은 조건의 상위 모델은 불일치로 표시하지 않습니다. 적지 않으면 모델에 라이선스가 없으므로 판정이 review로 나옵니다. 라이선스는 스캔할 때 SBOM에 들어가므로, 나중에 빈 항목 채우기로 바꾼 라이선스는 다시 스캔할 때까지 확인 필요로 나옵니다.
데이터셋 카드에 원천이 적혀 있지 않은 경우가 많아, 스캔이 원천을 추적하지 못하기도 합니다. 선언에서 데이터셋마다 원천을 적을 수 있습니다(sources[], 웹 UI 질문의 "이 데이터의 원천" 항목). HuggingFace ID로 적은 원천은 다음 스캔에서 위험 판정 전에 허브에서 읽으므로, 기록된 라이선스가 추적한 원천과 똑같이 그 데이터셋의 판정에 반영됩니다. 이름으로만 아는 원천은 적은 라이선스와 함께 SPDX 3.0.1 문서에 기록되고, 직접 입력했으며 확인되지 않은 것으로 표시되며, 판정은 바꾸지 않습니다. 변환기가 거부한 선언은 이 단계에서도 적용하지 않습니다. 모델 카드에 적힌 데이터셋(또는 스캔 대상인 데이터셋) 가운데 어디에도 원천이 기록되지 않은 것은 검사 결과에 확인 필요로 나옵니다.
두 가지 규칙을 지킵니다. 스캔에 없고 선언하지도 않은 값은 추정하지 않고 비워 두며, 기반 모델은 id와 라이선스로만 기록하므로 모델에 대해 선언한 내용이 기반 모델로 옮겨지지 않습니다. --no-spdx3를 주면 이 문서를 만들지 않습니다.
모델을 실행하는 서비스
모델 카드는 모델을 설명합니다. G7 체크리스트는 그 모델을 둘러싼 시스템도 묻습니다. 시스템의 이름, 제작자, 버전, 데이터가 시스템 안에서 어떻게 흐르는지, 받은 데이터를 어떻게 쓰는지, 입력과 출력, 어느 분야에 쓰려는지입니다. 이 내용은 모델 카드에도 가중치 파일에도 없으므로, 그대로 두면 이 요소들은 사람이 검토할 항목으로 남습니다. 모델을 앱이나 API에 넣어 운영한다면 선언 파일에 그 서비스를 적을 수 있고, BomLens는 이를 두 문서에 모두 기록합니다. EU 인공지능법(AI Act)의 기술 문서 항목(Annex IV 1호)과 NIST AI 위험관리 프레임워크(AI RMF)의 MAP 1.1(의도한 목적과 사용 환경)도 같은 종류의 설명을 요구합니다. 여기서는 배경으로 소개할 뿐이며, 서비스를 선언했다고 해서 어느 쪽의 요구를 충족했다는 뜻은 아닙니다.
선언 파일에서 서비스는 최상위 service 객체입니다.
"service": {
  "name": "Acme Support Assistant",
  "packageVersion": "2.3.0",
  "downloadLocation": "https://support.acme.example/assistant",
  "suppliedBy": {"type": "Organization", "name": "Acme Corp"},
  "releaseTime": "2025-06-01T00:00:00Z",
  "informationAboutApplication": "Answers customer support questions in the web chat.",
  "domain": ["customer support"],
  "autonomyType": "no",
  "inputModality": ["text"],
  "outputModality": ["text"],
  "dataFlows": [
    {"flow": "inbound", "classification": "personal data",
     "description": "Customer questions typed in the chat window.",
     "source": ["https://support.acme.example/chat"]}
  ],
  "standardCompliance": ["ISO/IEC 42001:2023"],
  "disclosureUrl": "https://support.acme.example/ai-disclosure"
}
앞의 다섯 키는 SPDX가 서비스에 요구하는 필수 항목이며, 모두 적을 때까지 문서는 초안으로 남습니다. 나머지는 선택입니다. autonomyType은 AI의 결정에 사람이 관여하는지를 답합니다. no는 사람이 관여한다는 뜻이고, yes는 완전히 자동으로 동작한다는 뜻이며, noAssertion은 모른다는 뜻입니다. 키와 허용 값 전체는 산출물 레퍼런스에 있습니다. 웹 UI에서는 빈 항목 채우기와 모델 정보 직접 입력에 있는 선택 단계인 서비스 단계가 같은 내용을 묻습니다.
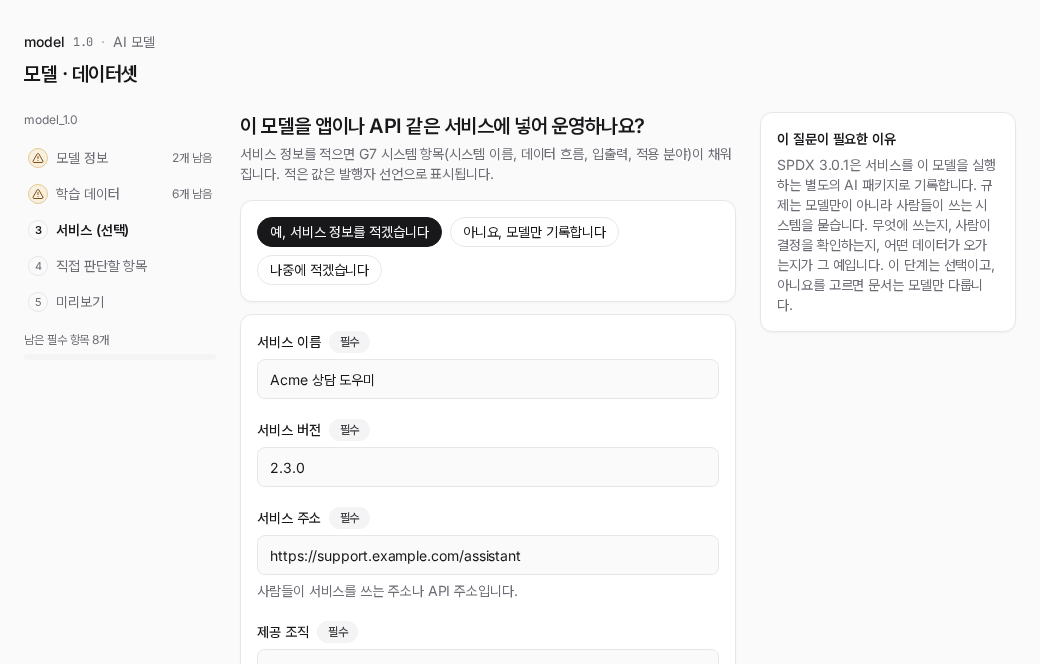
SPDX 3.0.1 문서는 서비스를 용도가 application인 ai_AIPackage로 쓰고, 실행할 때 모델에 의존하는 관계로 잇습니다. 문서의 루트는 계속 모델입니다. 스캔은 서비스를 CycloneDX SBOM에도 기록합니다. 선언한 데이터셋 원천을 읽은 다음, 위험 판정과 G7 검사보다 먼저 도는 단계입니다. 서비스는 services[]에, 그 데이터 흐름은 data[]에, 모델과의 의존 관계는 dependencies[]에, 적은 표준은 declarations.claims[]에 들어갑니다. 모두 bomlens:origin=declared-input으로 표시하고, 표준 항목의 근거(reasoning)에는 발행자 선언이며 BomLens가 확인하지 않았다고 적습니다.
서비스를 선언하면 G7 시스템 속성 요소가 그 값을 읽습니다. SBOM의 루트가 시스템 이름, 제작자, 버전을 주지 않을 때의 이 세 요소, 그리고 시스템 데이터 흐름, 시스템 데이터 사용(데이터 흐름의 설명), 시스템 입출력 속성, 적용 대상 분야입니다. 이렇게 채워진 요소는 "있음 (발행자 선언, BomLens가 확인하지 않음)"으로 나오고, 웹 UI는 "발행자 선언" 배지를 붙입니다. BomLens는 적은 내용을 기록할 뿐, 서비스가 실제로 그렇게 동작하는지는 확인하지 않습니다. 다른 도구가 만든 SBOM도 서비스에 CycloneDX data(serviceData) 항목이 있으면 인정합니다. 흐름 방향이 있으면 데이터 흐름을, 설명이 있으면 데이터 사용을 충족하고, 이때는 일반 충족으로 나옵니다. standardCompliance에 보안 표준을 적어도 보안 준수 요소는 충족되지 않으며 검토 항목으로 남습니다.
CycloneDX SBOM은 스캔할 때만 바뀝니다. 스캔 뒤 웹 UI에서 저장한 서비스는 SPDX 문서에는 바로 들어가지만, CycloneDX SBOM과 G7 검사에는 다음 스캔에서 반영됩니다. 그때까지 SPDX 검사 결과는 service.state를 pendingScan으로 알리고, 모델·데이터셋 화면의 띠에 다시 스캔 버튼이 나옵니다. --ai-declare로 넘긴 선언은 같은 실행에서 반영됩니다.
외부 AI 모델
서비스는 직접 실행하지 않는 모델을 호출하기도 합니다. 외부에서 제공하는 번역 API나 임베딩 API가 그런 예입니다. 이런 모델은 service.externalModels[]에 적습니다. 항목마다 key와 name은 반드시 적고, suppliedBy, packageVersion, endpoint는 선택입니다. 기록하는 것은 식별 정보뿐입니다. SPDX 문서에는 용도가 model인 software_Package로, CycloneDX에는 선언한 서비스가 의존하는 별도 서비스로 services[]에 들어갑니다. BomLens는 이 모델에 관해 아무것도 읽어 오지 않습니다. 위험 판정 대상도 아니고, G7 검사에서 모델로 세지도 않습니다.
규제 제출용 정보
대형 범용 모델에 관한 규정은 모델 카드에 없는 수치를 요구합니다. 선언의 model 항목은 이런 값 세 가지를 받습니다.
trainingComputeFlops는 모델 학습에 쓴 연산량을 부동소수점 연산 횟수(FLOPs)로 적은 값이며,"3.2e24"처럼 10진수 문자열로 씁니다. 산정 방법은trainingComputeBasis에 적습니다. EU 인공지능법은 범용 AI 모델의 기술 문서에 학습 연산량을 적도록 하고(Annex XI 1절 2(d)), 제51조 제2항에서 이 값으로 고영향 능력을 추정합니다. 인공지능기본법 시행령 제24조도 학습 연산량을 다룹니다.adversarialTesting(yes,no,noAssertion)은 레드팀 같은 적대적 시험을 했는지를 적습니다. EU 인공지능법 제55조 제1항 (a)호는 시스템적 위험이 있는 범용 AI 모델의 제공자에게 이 시험을 수행하고 기록하도록 요구합니다.
조문은 이 필드가 왜 있는지 알리려고 적었습니다. BomLens는 수치를 기준값과 비교하거나 규정이 모델에 적용되는지 판단하지 않으며, 이 값을 채웠다고 해서 어느 규정을 준수하게 되는 것도 아닙니다.
model 항목에는 inputModality와 outputModality(text, image, audio, video, timeseries, structured, code, other)도 적을 수 있습니다. 다섯 값 모두 SPDX 문서와 CycloneDX SBOM의 모델 컴포넌트에 들어갑니다. 규제 값 셋은 bomlens:regulatory:* 속성으로, 입력과 출력 종류는 modelCard.modelParameters의 형식(format)으로 기록합니다. 스캔이 이미 입력이나 출력을 기록했다면 스캔한 값을 그대로 둡니다. 선언에서 채운 위치마다 bomlens:declared 속성이 붙습니다.
이전 버전의 BomLens
BomLens v1.13 이하는 이 키를 모릅니다. service나 새 모델 키가 있는 선언은 값을 말없이 버리지 않고 "unknown key(s)" 오류로 거부합니다. 이런 파일은 이 키를 지원하는 버전으로 읽거나, 해당 키를 지운 뒤 씁니다. SPDX 2.3 내보내기와 --diff도 서비스를 다루지 않습니다. SPDX 2.3 사본은 CycloneDX SBOM의 컴포넌트로 만들고, --diff는 모델과 컴포넌트를 비교하기 때문입니다.
적합성 검사 보고서 읽는 법
G7 블록의 머리에는 "N / 41 충족" 같은 수치가 옵니다. 분모는 자동 출처가 있는 검사만 셉니다. 51개 중 41개이므로, 이 숫자는 도구가 스스로 확인할 수 있었던 범위를 말합니다. 사람 검토 전용 10개는 그 옆에 "검토 필요" 건수로 따로 표시되고, 자동 검사 중 채워지지 않은 것은 권고 건수로 잡힙니다. 10개 중 시스템 데이터 흐름, 시스템 데이터 사용, 시스템 입출력 속성, 적용 대상 분야의 네 개는 SBOM에 값이 생기면 검토 필요 건수에서 빠지고 분모에 들어갑니다. 서비스를 선언하면 이 값이 생깁니다.
각 검사의 상태는 세 가지입니다. 충족(pass)은 해당 요소가 ML-BOM에 있다는 뜻입니다. 권고(warn)는 없거나 확인하지 못했다는 뜻이고, 검토 전용 요소는 항상 이 상태로 사람 검토가 필요하다는 표시와 함께 나타납니다. 실패(fail)는 G7 검사에서는 사실상 나오지 않습니다. G7 요소는 전부 권고라서 하나가 비어도 SBOM 전체 판정을 실패로 만들지 않으며, 전체 실패 판정은 기본 형식 검사(필수 CycloneDX 검사)에서만 나옵니다.
일부 행은 해당 없음으로 표시되고 요약에 건수가 따로 잡힙니다. 문서가 판정할 근거를 주지 않는 검사입니다. 구성요소가 없는데 보유율을 재는 경우, 또는 모델 하나만 대상인 문서에서 부품 간 의존 관계를 묻는 경우가 그렇습니다. 이런 검사는 충족으로 세지 않고 분자와 분모에서 모두 빠집니다. 충족으로 세면 데이터셋을 밝히지 않은 카드가 밝힌 카드보다 높게 나오기 때문입니다. 검토 필요와도 다릅니다. 검토자가 볼 것이 없기 때문입니다. 학습 데이터셋을 적은 카드는 실제로 측정되는 검사가 더 많으므로, 분모가 작은 쪽이 더 좋은 결과라는 뜻이 아닙니다.
각 행의 출처 배지는 충족된 값이 어디서 오는지를 말합니다.
- 자동 확인(22건): ML-BOM 필드에서 직접 읽습니다.
- 신호 추정(15건): 전용 필드 하나가 아니라 BOM 안의 신호로 도출합니다.
- 선언 필요(8건): 사람이나 매니페스트가 값을 제공했을 때만 채워집니다. 이 중 네 개(시스템 데이터 흐름, 시스템 데이터 사용, 시스템 입출력 속성, 적용 대상 분야)는 SBOM에 값이 생길 때까지 검토 필요로 나옵니다. 발행자의 선언으로 충족된 경우에는 세부 내용에 그렇다고 적습니다.
- 검토 필요(6건, 위의 네 개를 더하면 10건): 자동 출처가 없어 사람이 직접 확인해야 합니다.
같은 결과가 세 가지 형식으로 나옵니다. 기계용 {Project}_{Version}_conformance.json(CI 게이트, 비교용), 표 형태의 _conformance.md, 시각화한 _conformance.html입니다. 각 형식에는 규제 크로스워크도 함께 담기며, JSON에서는 매핑된 검사가 하나 이상 평가됐을 때만 regulatoryCrosswalk 객체로 나타납니다.
보고서는 무엇이 비었는지에 더해 어떻게 채우는지도 보여 줍니다. 자동 출처가 있는데 비어 있는 요소마다 CycloneDX 조각과 공식 문서 링크가 따라붙습니다. HTML에서는 해당 행의 "근거 · 채우는 방법" 칸을 펼치면 나오고, Markdown에서는 "How to fill the gaps" 절에 모여 나옵니다. 이미 통과한 요소와 검토 전용 요소는 제외되므로, 문서화가 충실한 모델에서는 아무것도 나오지 않습니다.
실제 사례
한 번 돌려 보면 나머지를 읽기가 쉬워집니다. FINAL-Bench/Aether-7B-5Attn은 허깅페이스에 Apache-2.0으로 공개된 파운데이션 모델로, 가중치와 구조, 학습 데이터, 학습 과정을 모두 공개했습니다. 문서화가 충실한 모델 카드가 어떤 결과를 내는지 보여 주는 예입니다.
./scripts/scan-sbom.sh --project Aether-7B-5Attn --version 1.0 \
  --model "FINAL-Bench/Aether-7B-5Attn" --generate-only
2026-10-23에 스캔한 결과(모델 리비전 da711bdb)는 result=pass에 G7 요소 41개 중 30개 충족입니다. 수치는 모델 카드 내용을 따르므로 이후 리비전에서는 달라질 수 있습니다. Models 클러스터는 14개 중 12개가 통과하며, SBOM에 모델 타임스탬프와 모델 설명이 없습니다. 공개성 패널은 네 축 전부 열림으로 표시됩니다.
| 축 | 값 |
|---|---|
| 가중치 | open-weight |
| 구조 | open-architecture |
| 학습 데이터 | open-data |
| 학습 과정 | open-training |
모델 카드가 데이터셋을 명시하므로, BomLens는 학습에 쓰인 7종(FineWeb-Edu, SmolLM 코퍼스, FineMath, open-web-math, OpenCoder 코드 코퍼스, HAERAE-HUB의 한국어 두 종)을 하나씩 조회해 각 데이터셋이 밝힌 내용을 기록합니다. 데이터셋 속성 10개 중 8개가 충족으로 나옵니다. 남는 두 개는 데이터의 통계 속성과 개인정보·저작물 포함 여부인데, 저장소를 읽어서는 알 수 없는 항목이라 보고서는 추측하지 않고 사람에게 확인을 요청합니다.
조회를 하기 때문에 드러나는 것이 다음 대목입니다. 7종 중 네 종이 라이선스를 밝히고 있습니다. FineWeb-Edu, FineMath, SmolLM 코퍼스는 odc-by, OpenCoder 코퍼스는 MIT입니다. 나머지 세 종(HAERAE-HUB 두 종과 open-web-math)은 라이선스 표기가 없습니다. 데이터셋 이름만 세었다면 이 모델의 학습 데이터는 완전히 공개된 것으로 읽혔을 것입니다. 실제로 조회해 보면, Apache-2.0으로 공개된 모델의 학습 자료 일부가 라이선스 미표기 상태라는 사실이 드러납니다. 도구가 판단할 일은 아니지만 공개 전에 검토자가 알아야 할 사실이며, 데이터셋을 하나씩 열어 봐야만 보입니다.
같은 명령으로 만든 보고서를 그대로 열어 볼 수 있습니다. 베이스 모델의 적합성 검사 보고서입니다. 이 보고서는 위 결과와 같은 2026-10-23 실행에서 생성했습니다. AI 준수 개요가 담던 클러스터별 충족 현황과 검토 대상 라이선스가 이 보고서 맨 위에 함께 나옵니다. 한국어 보고서는 --lang ko로 생성합니다.
다음 단계
보고서가 나왔다고 검토가 끝난 것은 아닙니다. 도구가 채울 수 있는 항목과 사람이 판단해야 하는 항목이 나뉩니다.
- 자동 출처가 있는데 비어 있는 항목을 모델 카드에 채우고 다시 스캔합니다. 채우는 형태는 보고서의 해당 행에서 확인할 수 있습니다.
- 검토 전용 10개 요소를 사람이 확인합니다. 학습 데이터의 민감도나 의도한 적용 분야처럼 모델 카드의 어떤 필드로도 증명되지 않는 것들입니다. 모델을 서비스에 넣어 운영한다면 그 서비스를 선언해 이 중 네 개를 채울 수 있습니다(모델을 실행하는 서비스 참고).
- 학습 데이터셋 라이선스와 개인정보처럼 이 도구가 보지 않는 사안을 별도로 확인합니다.
사내에서 AI 모델을 공개하기 위해 쓰신다면, 승인 절차와 공개 전 점검 항목은 SK텔레콤 오픈소스 가이드의 AI 모델 공개에 있습니다.
G7 체크리스트란
"G7 Software Bill of Materials for AI — Minimum Elements"는 2026년 5월 G7 차원에서 발행된 지침으로, 독일 BSI와 이탈리아 ACN이 주도했습니다. AI 모델의 SBOM이 갖춰야 할 최소 요소 50개를 7개 클러스터로 정의합니다. 누가 만든 모델인지, 무엇인지, 어떤 데이터로 학습했는지, 어떻게 보호되는지, 성능은 어떤지를 다룹니다. 법적 구속력이 있는 규정이 아니라 권고입니다.
그래도 규제와 무관하지 않습니다. EU 인공지능법(AI Act)의 고위험·투명성 의무가 2026년 8월 2일부터 적용되고, Annex IV가 요구하는 기술 문서는 G7 클러스터와 상당 부분 겹칩니다. 적합성 검사 보고서가 주는 것은 가시성입니다. 모델 문서가 이미 다루는 요소와 사람이 채워야 할 요소를 항목별로 보여주므로, 준수 판정이 아니라 준비를 돕는 구체적인 방법이 됩니다(이 보고서가 인증하지 않는 것은 한계를 참고하세요).
BomLens는 50개 요소를 51개 검사로 보여줍니다. 모델 개방성(가중치, 아키텍처, 학습 데이터, 학습 과정의 공개 여부)은 G7 원문에서 Model license 요소의 한 측면이지만, 따로 볼 가치가 있어 별도 행으로 노출합니다.
| 클러스터 | 검사 수 | 그중 사람 검토 |
|---|---|---|
| 메타데이터 | 10 | 0 |
| 시스템 속성 | 9 | 4 (서비스로 채우면 0) |
| 모델 | 14 | 0 |
| 데이터셋 속성 | 10 | 2 |
| 인프라 | 2 | 0 |
| 보안 속성 | 4 | 3 |
| 핵심 성과 지표 | 2 | 1 |
10개 요소는 자동으로 확인할 출처가 없습니다. 의도된 적용 분야나 데이터셋 민감도처럼 모델 카드의 어떤 필드로도 증명할 수 없는 것들입니다. BomLens는 이를 추측하는 대신 사람 검토가 필요하다고 표시합니다. 시스템 속성의 네 요소(데이터 흐름, 데이터 사용, 입출력 속성, 적용 대상 분야)는 CycloneDX services[]에서 읽습니다. 네 요소 모두 선언한 서비스에서 읽고, 데이터 흐름과 데이터 사용은 다른 도구가 만든 SBOM의 서비스에서도 읽습니다. SBOM에 값이 생기면 그 요소는 더 이상 검토 항목으로 세지 않습니다.
규제 크로스워크
적합성 검사 보고서는 규제와 대응되는 검사마다 그 검사가 어느 문서화 의무와 닿는지를 연결해 줍니다. 검토자가 던지는 질문에 답하기 위한 것입니다. 어떤 검사가 미달일 때, 그 공백이 어느 규제 요구와 관련되는가? 참고 규정은 검사 표에서 해당 요구사항 행 아래에 붙고, 상세 위의 크로스워크 절이 프레임워크마다 한 행씩, 매핑된 검사 중 충족, 공백, 검토 필요가 몇 건인지 집계해 보여 줍니다.
AI 여부와 관계없이 분석하는 모든 SBOM에는 두 가지 프레임워크가 매핑됩니다.
- EU 사이버복원력법(CRA) — CRA 준수를 위해 작성된 독일 기술지침이자 공개된 것 중 가장 상세한 SBOM 필드 명세인 BSI TR-03183-2를 통해 연결합니다(CRA 본문은 데이터 필드를 지정하지 않습니다). TR-03183-2는 국가 지침이며, 구속력 있는 문구를 담을 유럽 조화 표준은 아직 초안 단계입니다.
- 미국 SBOM 최소 요소 — 2026년판 최소 요소의 데이터 필드 17개와 운영 원칙 6개. CISA와 NSA, FBI가 15개 해외 기관과 함께 발표했고 2021년 NTIA 문서를 대체합니다. 이후 연방 차원의 SBOM 수집 의무는 기관별 위험 기반 판단으로 축소되었지만, 개별 기관이 요구하는 실무 기준으로는 여전히 유효합니다.
위 크로스워크는 SBOM 데이터 필드만 다룹니다. 이 필드가 속한 CRA 준비 절차 전체(거버넌스, 취약점 대응, 기술문서, 보안 업데이트)는 커뮤니티가 관리하는 OpenChain CRA Compliance Requirements & Checklist를 참고하세요.
AI SBOM에는 G7 요소에 대응하는 두 가지 프레임워크가 더해집니다.
- EU 인공지능법(AI Act) — Annex IV 기술문서 항목(Regulation (EU) 2024/1689, Article 11(1)).
- AI 기본법(한국) — 투명성(제31조), 안전성과 위험관리(제32조), 고영향 인공지능(제33·34조), 영향평가(제35조) 조항. 이 법은 기본법 성격이라 매핑이 EU 쪽보다 성깁니다.
크로스워크는 준수 판정이 아니라 준비를 돕는 자료입니다(한계 참고). 각 매핑에는 그 연결의 해석 근거를 함께 담아 사람이 판단할 수 있게 했고, 크로스워크가 검사 상태나 전체 판정을 바꾸지는 않습니다. 검사가 이미 낸 결과를 규제별로 다시 묶을 뿐입니다.
매핑은 검사 id를 키로 삼아 docker/lib/regulation-crosswalk.json에 있습니다. AI 검사는 G7 요소 id, 기본 형식 검사는 일반 CycloneDX 검사 id를 씁니다. 의도적으로 보수적으로 잡아, 근거가 분명한 검사만 매핑합니다. 현재 검사 id 74개가 네 프레임워크에 걸쳐 84건으로 연결되어 있습니다. 검사 하나가 여러 프레임워크에 연결될 수 있어 두 수치가 다릅니다. 검사 이름이 바뀌어도 크로스워크가 조용히 어긋나지 않도록, 매핑된 모든 id를 레지스트리와 대조하는 테스트를 둡니다.
AI 준수 개요
AI SBOM에서는 BomLens가 한 장짜리 AI 준수 개요(_ai-profile.{json,md,html})도 만듭니다. 원래는 여러 산출물에 흩어져 있던 것을 한곳에 모읍니다. 클러스터별 G7 상태, 규제 크로스워크, 그리고 라이선스가 검토 대상으로 표시된 컴포넌트(AI 행동제약이나 비상업 라이선스)입니다. 스캔을 새로 돌리지 않고 준수 판정도 하지 않습니다. 파이프라인이 이미 만든 결과를 다시 묶어, 검토자가 전체 그림을 한눈에 읽게 할 뿐입니다. AI 모델(--model)과 공급사 SBOM(--analyze) 경로에서 생성되며, 일반(비AI) SBOM에서는 아무것도 만들지 않습니다.
모델 위험 판정
AI 준수 개요에는 모델별 사용 가능성 판정도 담깁니다. 개발팀이 가장 먼저 묻는 질문, 즉 이 모델을 써도 되는지, 조건은 무엇인지에 답하기 위한 것입니다. 각 모델과 데이터셋 항목은 파이프라인이 근거를 가진 축에 대해 평가되어 네 가지 판정 중 하나를 받습니다.
| 판정 | 의미 |
|---|---|
| 제약 신호 없음(ok) | 알려진 무제약 신호만 있는 경우. 예를 들어 허용적 라이선스입니다. |
| 조건부 사용(conditional) | 제시된 조건을 지키면 사용할 수 있는 경우. 예를 들어 Llama 커뮤니티 라이선스의 사용자 수 조건과 명칭 규칙, 카피레프트 라이선스의 고지 의무입니다. |
| 주의(caution) | 알려진 차단 신호가 있는 경우. 예를 들어 비상업 라이선스나 연구 목적 한정 라이선스입니다. |
| 검토 필요(review) | 도구가 판정할 수 없는 경우. 등록되지 않은 라이선스, 라이선스 누락, 읽을 수 없는 데이터셋 등이며 사람이 확인해야 합니다. |
파일 보안 축은 Hugging Face가 모든 저장소에 자체 실행하는 스캔 결과를 읽습니다. 악성코드는 ClamAV로, 로드 시 코드가 실행될 수 있는 pickle import는 picklescan으로 파일마다 검사한 결과입니다. BomLens는 파일을 하나도 내려받지 않고 메타데이터 API로 이 결과를 읽어, 가장 나쁜 상태와 문제 파일 이름을 기록하고, 가중치가 pickle 계열 형식(로드 시 코드 실행 가능)인지 safetensors 같은 안전한 형식인지도 함께 남깁니다. 스캔이 아직 끝나지 않은 모델은 안전이 아니라 검토 필요로 읽습니다. 조회를 건너뛰려면 ENRICH_HF_SECURITY=false로 설정합니다.
라이선스 판정은 Hugging Face 라이선스 태그 전체 목록을 담은 등록부(docker/lib/ai-risk-knowledge.json)에서 나옵니다. 각 항목은 상업 이용·재배포·파생 허용 여부, 적용되는 조건, 라이선스 원문 링크를 기록하고, 개요 보고서는 판정 옆에 요약과 조건을 함께 인쇄해 근거가 판정과 같이 다니게 합니다. 등록부에 없는 라이선스는 추측하지 않고 검토 필요로 내려갑니다. 모델의 종합 판정은 평가된 축 가운데 가장 나쁜 판정을 따르고, 아무것도 평가하지 않은 축은 안전으로 읽히는 대신 미평가로 표시됩니다.
라이선스 판정을 더 깊게 만드는 검사가 두 가지 있습니다. other로 표시된 모델은 저장소의 LICENSE 파일(작은 텍스트 파일 하나로, 가중치는 여전히 내려받지 않습니다)을 읽어 비상업·연구 한정·파생 금지 같은 제한 문구를 찾습니다. 문구가 발견되면 해당 문장을 판정 옆에 그대로 인용하므로, 보고서가 "미분류"라고만 말하는 대신 "이 문장 때문에 검토가 필요하다"고 말합니다. 문구가 발견되지 않아도 판정은 검토 필요로 유지됩니다. 패턴에 안 걸렸다는 것이 제한이 없다는 증거는 아니기 때문입니다. 파인튜닝 모델은 선언된 base_model 체인을 최대 다섯 단계까지 따라가며 라이선스를 비교합니다. 조건이 파생물에 승계되는 라이선스(Llama, Gemma, RAIL 계열, 비상업 CC)를 가진 상위 모델이 있는데 모델 자신은 다른 라이선스를 표시하고 있으면 불일치를 주의로 표시합니다. 허브에서 흔한 오표기이며, 태그만 보는 검사로는 잡을 수 없는 부분입니다.
데이터셋 축은 참조된 데이터셋들을 모델 판정으로 끌어올립니다. 각 데이터셋 항목은 자체 라이선스와 함께, 제작자가 스스로 붙인 위험 표시로 판정됩니다. pii(개인식별정보)나 not-for-all-audiences 같은 태그, 그리고 접근 제한(gated·비공개 저장소)이 그 대상입니다. 모델은 데이터셋 중 가장 나쁜 판정을 따르고, 해당 데이터셋 이름을 함께 보여 줍니다. 이 표시는 제작자의 자기 신고이므로 없다고 해서 안전하다는 뜻이 아니며, 판정을 올리는 데만 쓰이고 내리는 데는 쓰이지 않습니다.
추적한 원천도 같은 방식으로 판정하고, 그 결과를 원천에서 나온 데이터셋의 판정에 반영합니다. 데이터셋 아래 어디에서든 가장 엄격한 판정이 그 데이터셋의 판정이 되고, 사유에는 원천과 그 라이선스가 나옵니다(예: source org/nc: cc-by-nc-4.0 (caution)). 읽을 수 없거나, 라이선스를 밝히지 않았거나, 문장으로만 적힌 원천은 검토 필요입니다. 깊이 상한 아래 원천은 읽지 않았으므로, 그런 원천이 있는 데이터셋도 검토 필요입니다. 이 규칙은 기록된 라이선스만 봅니다. 원천의 권리자가 파생 데이터를 다른 조건으로 다시 허락했는지는 알 수 없습니다.
판정은 실제 사용 형태에 맞출 수 있습니다. --usage에 internal(내부 검토와 연구), product(제품이나 서비스 탑재), redistribute(파인튜닝 후 재배포), outputs-only(산출물만 이용) 중 하나를 주면, 그 사용 형태에 적용되는 라이선스 조건만으로 판정합니다. 예를 들어 비상업 라이선스 모델은 내부 연구용이면 조건부 사용, 제품 탑재면 주의로 갈립니다. 보고서에는 어떤 사용 형태 기준으로 판정했는지 항상 표시되며, --usage가 없으면 전체 조건 기준으로 판정합니다.
./scripts/scan-sbom.sh --project my-llm --version 1.0 \
  --model "meta-llama/Llama-3.3-70B-Instruct" --usage product --generate-only
이 판정은 법적 자문이 아닌 안내이며, 판정을 인쇄하는 모든 보고서에 그 문구가 함께 실립니다. 검토자에게 필요한 것, 곧 조건과 출처와 미확인 사항을 한곳에 모아 주고, 최종 판단은 근거를 갖춘 사람이 내리게 합니다.
한계
- 읽을 수 없는 모델은 SBOM을 아예 만들지 않습니다. 조회에 실패하면 생성기가 카드를 일반적인 기본값으로 채우기 때문에, BomLens는 생성기 로그를 확인해 실행을 중단합니다. 통과처럼 읽히는 껍데기 명세를 돌려주지 않기 위해서입니다.
- 결과는 HuggingFace 모델 카드만큼만 충실합니다. 카드가 빈약하면 ML-BOM도 빈약하고, G7 검사도 카드에 문서화된 범위를 반영할 뿐 모델 자체를 감사하지는 않습니다.
- 데이터셋 항목은 그 데이터셋이 스스로 밝힌 내용을 기록합니다. 원천의 기록된 조건이 파생 데이터셋보다 엄격하면 이제 판정이 보여 주지만, 표기된 라이선스가 타당한지, 원천이 파생 용도에 맞게 다시 허락되었는지는 보고서가 판단하지 않고 검토자에게 남깁니다. 카드가 적지 않은 원천은 추적할 수 없습니다.
- 복합 SPDX 라이선스 표현식(
MIT OR Apache-2.0)은 선택지를 해석하지 않고 전체를 하나로 판정하므로, 어느 한쪽만으로는ok가 될 이중 라이선스 모델이review로 나올 수 있습니다. 방향은 의도적으로 보수적이어서 위험을 낮게 잡지는 않지만 과하게 표시할 수 있습니다. 보고서에 표현식 원문을 그대로 적어 검토자가 확인할 수 있게 합니다. - 적합성 검사 보고서는 EU 인공지능법, 한국 AI 기본법을 비롯한 어떤 규제의 준수도 인증하지 않습니다. 문서화 공백을 드러내 사람이 메울 수 있게 할 뿐입니다.
- 메타데이터를 네트워크로 가져오므로 오프라인 사용은 지원하지 않습니다. 비공개 모델과 게이트 모델에는
HF_TOKEN이 필요합니다(비공개 모델과 게이트 모델 참고). - 모델 id는
org/model형식이어야 합니다. 컬렉션 이름이나 전체 URL은 해석되지 않습니다.
관련 문서: 입력 형태별 파이프라인 | 웹 UI 레퍼런스 | CLI 레퍼런스